
مقالات تجربه کاربری - تست A/B
تست A/B
 تست A/B
تست A/B (A/B Testing) چیست؟
💡 این متن «بازنویسی آزاد» است: ایدهها و مفاهیم مطلب اصلی با نگارش کاملاً مستقل فارسی و مثالهای تازه بازگو شدهاند و ترجمهٔ کلمهبهکلمه نیست. بخشهای افزودهٔ مترجم در جعبهٔ منبع مشخص شدهاند.
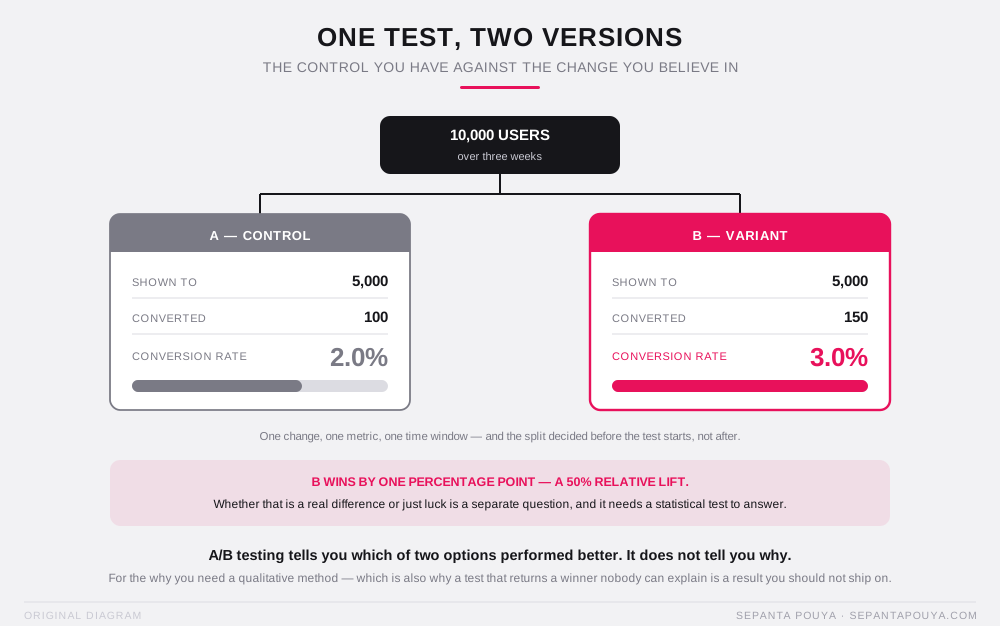
تست A/B یک روش پژوهش کمّی است: دو نسخه از یک طراحی را همزمان به دو گروه از کاربران واقعی نشان میدهیم و میسنجیم کدامیک بهتر به هدف مشخصی میرسد. نسخهٔ A معمولاً همان چیزی است که الان دارید (نسخهٔ کنترل) و نسخهٔ B تغییری است که فکر میکنید بهتر جواب میدهد.
ارزش این روش در چیزی است که جایگزینش میکند. بدون تست A/B، تصمیم بین دو طرح را معمولاً ارشدترین آدم اتاق میگیرد یا آنکسی که بلندتر حرف میزند. با تست A/B، تصمیم را رفتار هزاران کاربر واقعی میگیرد. اما — و این «اما» تمام مقاله است — فقط وقتی که درست اجرا شود. وگرنه عددی به شما میدهد که دقیق به نظر میرسد و اشتباه است، و این از نداشتن عدد خطرناکتر است.
چطور کار میکند
ساختار پایه ساده است و در چند قدم خلاصه میشود:
- - ۱. یک هدف مشخص انتخاب کنید. «بهتر شدن تجربه» هدف نیست. «نرخ تکمیل ثبتنام» یا «نسبت کاربرانی که سبد خرید را نهایی میکنند» هدف است. این عدد را پیش از شروع تعیین کنید، نه بعد از دیدن نتایج.
- - ۲. فقط یک چیز را تغییر دهید. اگر همزمان متن دکمه، رنگ آن و چیدمان صفحه را عوض کنید، در پایان میدانید نسخهٔ B بهتر بود اما نمیدانید بهخاطر کدام تغییر. همین یعنی چیزی یاد نگرفتهاید.
- - ۳. ترافیک را تصادفی تقسیم کنید. هر کاربر بهطور تصادفی به یکی از دو نسخه میرود و تا پایان آزمون در همان نسخه میماند. تصادفی بودن مهمترین شرط است؛ اگر مثلاً نسخهٔ B را فقط به کاربران اپلیکیشن نشان دهید و A را به کاربران وب، دو گروه متفاوت را مقایسه کردهاید نه دو طرح را.
- - ۴. تا رسیدن به حجم نمونهٔ لازم صبر کنید. این حجم را باید پیش از شروع حساب کنید. نه اینکه هر روز نگاه کنید و هر وقت عدد خوب شد متوقفش کنید.
- - ۵. نتیجه را از نظر آماری بسنجید. یعنی مطمئن شوید تفاوتی که میبینید واقعی است و صرفاً نوسان تصادفی نیست.
مثال بالا در تصویر ابتدای صفحه دقیقاً همین است. ده هزار کاربر در سه هفته به دو گروه پنجهزارتایی تقسیم شدهاند و نرخ تبدیل دو درصد در برابر سه درصد به دست آمده است.
معناداری آماری به زبان ساده
فرض کنید نسخهٔ A صد تبدیل داشته و نسخهٔ B صد و پنجاه تبدیل. آیا نسخهٔ B بهتر است؟ شاید. اما اگر همان آزمون را با همان دو طرح یک بار دیگر اجرا کنید، ممکن است عددها جابهجا شوند — چون بخشی از هر تفاوتی که میبینیم صرفاً شانس است. کاری که آزمون آماری میکند این است: میپرسد «اگر این دو طرح واقعاً هیچ فرقی نداشتند، احتمال اینکه چنین تفاوتی را تصادفاً ببینیم چقدر بود؟»
پاسخ این پرسش را عددی به نام p میدهد. هرچه این عدد کوچکتر باشد، احتمال اینکه نتیجه تصادفی باشد کمتر است. قرارداد رایج این است که اگر p کمتر از ۰٫۰۵ باشد، تفاوت را «معنادار» میدانیم. آزمونی که معمولاً برای این کار به کار میرود، «خیدو» (Chi-Square) است، چون دادههای ما شمارشیاند: چند نفر تبدیل شدند و چند نفر نشدند.
دو سوءتفاهم رایج را همینجا تمام کنیم. اول اینکه p کوچک نمیگوید تفاوت بزرگ است؛ فقط میگوید تفاوت احتمالاً واقعی است. با نمونهٔ خیلی بزرگ، حتی یک تفاوت بیاهمیت ۰٫۱ درصدی هم معنادار میشود. پس همیشه در کنار معناداری، به اندازهٔ تفاوت هم نگاه کنید و بپرسید آیا این اندازه ارزش هزینهٔ پیادهسازی را دارد یا نه.
دوم اینکه ۰٫۰۵ یک عدد مقدس نیست، یک قرارداد است. معنایش این است که از هر بیست آزمونی که در آن هیچ تفاوت واقعی وجود ندارد، بهطور متوسط یکی بهغلط «معنادار» میشود. اگر تیم شما ماهی بیست آزمون اجرا میکند، انتظار داشته باشید هر ماه یک نتیجهٔ کاملاً جعلی به دست بیاورید که هیچچیز جز شانس پشتش نیست.
چه میگوید و چه نمیگوید
تست A/B به شما میگوید کدام نسخه بهتر عمل کرد. به شما نمیگوید چرا. این محدودیت، ذاتی روش است نه نقص اجرا: شما فقط رفتار را میبینید، نه دلیلش را.
فرض کنید نسخهٔ B نرخ کلیک بالاتری دارد. آیا چون واضحتر است؟ چون جذابتر است؟ یا چون کاربر گیج شده و دنبال راه خروج میگشته و اتفاقاً روی همان دکمه رسیده؟ عدد به هیچکدام از اینها جواب نمیدهد. برای همین بهترین شکل استفاده، ترکیب این روش با روشهای کیفی است. آزمون کاربردپذیری با پنج کاربر به شما میگوید چرا. و تست A/B با ده هزار کاربر میگوید آیا آن «چرا» در مقیاس بزرگ هم اثر دارد یا نه. هیچکدام جای دیگری را نمیگیرد.
دو محدودیت دیگر هم هست که کمتر گفته میشود. اول اینکه این روش به محصول زندهٔ پرترافیک نیاز دارد. اگر روزی صد نفر از صفحهٔ شما عبور میکنند، رسیدن به نتیجهٔ معنادار ماهها طول میکشد و در آن مدت خود محصول عوض شده است. دوم اینکه ذاتاً کوتهبین است. تغییری که امروز نرخ کلیک را بالا میبرد ممکن است در سه ماه اعتماد کاربر را از بین ببرد، و آزمون دو هفتهای این را هرگز نشان نمیدهد. این دقیقاً همان لغزشگاهی است که بحث الگوهای فریبنده از آن شروع میشود — چون بسیاری از آن الگوها در تست کوتاهمدت، برندهاند.
تفاوت با آزمون چندمتغیره و آزمون کاربردپذیری
سه روشی که مدام با هم اشتباه گرفته میشوند:
- - تست A/B: دو نسخه، یک تفاوت. ساده، سریع و کمترافیکتر از بقیه. جواب میدهد: کدام بهتر است؟
- - آزمون چندمتغیره: چند عنصر همزمان و در همهٔ ترکیبهای ممکن آزموده میشوند. مزیتش این است که برهمکنش میان عناصر را نشان میدهد (مثلاً عنوان تازه فقط وقتی جواب میدهد که تصویر هم عوض شود)، اما به ترافیک بسیار بیشتر و زمان بسیار طولانیتری نیاز دارد. برای بیشتر تیمها، شروع با A/B عاقلانهتر است.
- - آزمون کاربردپذیری: اصلاً روش کمّی نیست. با تعداد کمی کاربر انجام میشود و هدفش فهمیدن دلیل و مشاهدهٔ مشکل است، نه اندازهگیری. جواب میدهد: چرا؟
یک قاعدهٔ سرانگشتی: اگر نمیدانید مشکل کجاست، تست A/B کمکی نمیکند — اول باید کیفی کار کنید. تست A/B ابزار انتخاب بین دو راهحل شناختهشده است، نه ابزار کشف مسئله. تیمهایی که این را جابهجا میگیرند، ماهها آزمونهای بینتیجه اجرا میکنند و آخرش میگویند «تست A/B برای ما کار نکرد».
خطاهایی که نتیجه را بیاعتبار میکنند
آزمون بد اجراشده، عدد تولید میکند اما دانش تولید نمیکند. پرتکرارترین خطاها اینهاست:
- - سرکشی و توقف زودهنگام: شایعترین و خطرناکترین خطا. هر روز نتیجه را نگاه میکنید و روزی که B جلو افتاد آزمون را تمام میکنید. با این کار عملاً تضمین میکنید که تفاوتهای تصادفی را بهعنوان نتیجهٔ واقعی برداشت کنید. حجم نمونه و مدت آزمون باید از اول تعیین و تا آخر رعایت شود.
- - اثر تازگی: کاربران قدیمی به تغییر واکنش نشان میدهند، نه لزوماً به بهتر بودنش. عنصر تازه در هفتهٔ اول کلیک بیشتری میگیرد و بعد به حالت عادی برمیگردد. آزمون باید دستکم یک چرخهٔ کامل رفتاری را بپوشاند.
- - بازههای ناهمگون: اگر آزمون شما وسط یک کمپین تخفیف یا در ایام نوروز اجرا شود، رفتاری را سنجیدهاید که نمایندهٔ روزهای عادی نیست. همیشه بازهٔ آزمون را شامل هفتهٔ کامل بگیرید تا تفاوت رفتار روزهای هفته خنثی شود.
- - آزمودن ده چیز و گزارشکردن یکی: اگر بیست شاخص را بررسی کنید، تقریباً همیشه یکیشان «معنادار» میشود. شاخص اصلی را از اول اعلام کنید و بقیه را فقط بهعنوان سرنخ برای آزمون بعدی نگه دارید.
- - نشتی میان دو گروه: کاربری که با موبایل نسخهٔ A و با لپتاپ نسخهٔ B را میبیند، هر دو گروه را آلوده میکند. اگر ورود کاربر دارید، تخصیص را به حساب کاربری ببندید نه به مرورگر.
و یک نکتهٔ اخلاقی که فنی نیست اما مهمتر از همهٔ موارد بالاست: شما دارید روی آدمهای واقعی آزمایش میکنید. آزمودن دو چیدمان بیضرر است؛ آزمودن اینکه کدام پیام اضطراب بیشتری ایجاد میکند تا کاربر سریعتر بخرد، چیز دیگری است. این مرز را تیم باید پیش از شروع برای خودش روشن کند، نه بعد از دیدن نتیجه.
تست A/B در محصولات ایرانی
اینها از کار با محصولات فارسیزبان میآید.
مسئلهٔ ترافیک. بیشتر محصولات ایرانی آنقدر کاربر روزانه ندارند که آزمونهای ظریف را در زمان معقول به نتیجه برسانند. راه عملی این است که سراغ تغییرهای بزرگ بروید نه ظریف: جابهجایی یک مرحلهٔ کامل از فرایند خرید، اثری میگذارد که با نمونهٔ کوچک هم دیده میشود؛ تغییر سایهٔ دکمه نه. اگر ترافیک واقعاً کم است، تست A/B ابزار شما نیست و آزمون کاربردپذیری و پژوهش کاربر بازدهی بسیار بیشتری دارند.
تقویم. نوروز، ماه رمضان، شب یلدا و بازههای تخفیف، الگوی رفتار خرید را کاملاً جابهجا میکنند. آزمونی که نیمی از آن قبل از نوروز و نیمی بعد از آن اجرا شود، عملاً بیمعناست. و یادتان باشد هفته از شنبه شروع میشود — یعنی بازهٔ «هفتروزه»ای که از سهشنبه شروع شود، دو آخر هفتهٔ ناقص را با هم مخلوط میکند.
راستبهچپ بودن. نتایج آزمونهای منتشرشدهٔ خارجی دربارهٔ جای عناصر — مثلاً اینکه دکمهٔ اصلی سمت راست بهتر است — در رابط راستبهچپ لزوماً برقرار نیست، چون مسیر نگاه آینه شده است. هر ادعایی دربارهٔ جای عناصر را باید روی مخاطب خودتان دوباره بیازمایید.
سنجش درست تبدیل. در بسیاری از محصولات ایرانی، پرداخت در درگاه بانکی خارج از سایت انجام میشود و بخشی از کاربران هرگز به صفحهٔ بازگشت نمیرسند. اگر «تبدیل» را با رسیدن به آن صفحه تعریف کنید، عدد شما بهشکل سیستماتیک کمتر از واقعیت است — و بدتر، این کمشماری ممکن است بین دو نسخه یکسان نباشد. مبنای سنجش را وضعیت نهایی سفارش در پایگاه داده بگذارید، نه بازدید یک صفحه.
چند نفر و چند وقت؟
حجم نمونه را پیش از شروع حساب کنید، نه در میانهٔ آزمون. حجم لازم به سه چیز بستگی دارد: نرخ فعلی، اندازهٔ بهبودی که میخواهید تشخیص دهید، و سطح اطمینانی که میپذیرید. نکتهٔ مهم و ضدشهودی این است که هرچه بهبود کوچکتری را بخواهید تشخیص دهید، نمونهٔ بزرگتری لازم است — و تشخیص بهبودهای یکدرصدی معمولاً از توان ترافیک بیشتر محصولات فارسیزبان بیرون است. اگر محاسبهٔ اولیه میگوید آزمون سه ماه طول میکشد، آن آزمون را اجرا نکنید؛ بهجایش تغییر بزرگتری بیازمایید یا سراغ روش کیفی بروید.
مدت را از قبل تعیین کنید و به آن پایبند بمانید. بدترین کار ممکن، سرزدن مکرر به نتیجه است. توقف آزمون در لحظهای که عدد دلخواهتان را نشان میدهد خطاست، چون با نگاهکردن مکرر، دیر یا زود یک تفاوت تصادفی «معنادار» به نظر میرسد. دو قاعدهٔ عملی: مدت را دستکم یک هفتهٔ کامل بگذارید تا چرخهٔ هفتگی رفتار کاربر پوشش داده شود، و پیش از شروع بنویسید که در چه تاریخی و با چه آستانهای تصمیم میگیرید.
و یک قاعدهٔ آخر که بیشترین وقت را نجات میدهد. اگر تغییرتان کوچک است، آزمون A/B ابزار غلطی است. عوضکردن سایهٔ یک دکمه، اثری ندارد که با هیچ حجم نمونهٔ معقولی قابل تشخیص باشد. این روش را برای تغییرهای ساختاری نگه دارید — حذف یک گام، عوضکردن مدل قیمت، بازنویسی کامل یک صفحه.
جمعبندی
تست A/B سادهترین شکل روش علمی در طراحی محصول است: یک فرضیه، دو گروه، و پذیرش اینکه ممکن است اشتباه کرده باشیم. قدرتش در این است که بحث سلیقهای را با شواهد جایگزین میکند. ضعفش در این است که فقط به پرسش «کدام» جواب میدهد و پرسش «چرا» را دستنخورده باقی میگذارد.
و اگر یک جمله بماند، همین باشد. آزمونی که پیش از شروع، شاخص و مدت و حجم نمونهاش تعیین نشده باشد، آزمون نیست — راهی است برای پیدا کردن عددی که حرف ما را تأیید کند. تفاوت این دو، تمام تفاوت میان یادگیری و خودفریبی است.
منبع
این نوشته «بازنویسی آزاد» است از مطلب What is A/B Testing? نوشتهٔ تحریریهٔ بنیاد طراحی تعامل (Interaction Design Foundation — IxDF). مفاهیم پایه — تعریف تست A/B، نسخهٔ کنترل و نسخهٔ جایگزین، تقسیم ترافیک، آزمون خیدو و مقدار p و آستانهٔ ۰٫۰۵، اهمیت حجم نمونه، محدودیت کیفینبودن روش، و تفاوت آن با آزمون چندمتغیره — از این منبع گرفته شده، اما متن فارسی، ساختار بخشها و همهٔ مثالها کاملاً مستقل نوشته شدهاند.
متن مطلب اصلی تحت هیچ لایسنس بازی منتشر نشده است؛ به همین دلیل اینجا ترجمهٔ کلمهبهکلمه ارائه نشده و متن کامل انگلیسی در لینک زیر در دسترس است. هر دو نمودار این صفحه بازطراحیشدهٔ مترجم است و جای تصاویر نسخهٔ اصلی را گرفته. نمودار اول همان مثالی را میکشد که متن به آن ارجاع میدهد (ده هزار کاربر، دو گروه پنجهزارتایی، دو در برابر سه درصد) و نمودار دوم همان اعداد را از آزمون خیدو میگذراند: خیدو برابر ۱۰٫۲۶ و p برابر ۰٫۰۰۱۴. هر دو عدد محاسبه شدهاند، نه نقلشده — و مثالِ «تفاوت بیاهمیتِ معنادار» هم با محاسبه انتخاب شده: تفاوت ۲٫۰ در برابر ۲٫۱ درصد در دویست هزار کاربر در هر گروه به p برابر ۰٫۰۲۶ میرسد.
بخشهای افزودهٔ مترجم: توضیح شهودی معناداری آماری و تفکیک آن از اندازهٔ اثر، و تفسیر آستانهٔ ۰٫۰۵ بهشکل «یک نتیجهٔ جعلی در هر بیست آزمون»؛ محدودیتهای کوتهبینی و نیاز به ترافیک بالا و پیوند آن با الگوهای فریبنده؛ قاعدهٔ سرانگشتی «A/B ابزار انتخاب است نه ابزار کشف مسئله»؛ کل بخش «خطاهایی که نتیجه را بیاعتبار میکنند» شامل توقف زودهنگام، اثر تازگی، بازههای ناهمگون، آزمودن چندشاخص و نشتی میان گروهها، بههمراه ملاحظهٔ اخلاقی آزمایش روی کاربر واقعی؛ و کل بخش «تست A/B در محصولات ایرانی» شامل مسئلهٔ ترافیک کم، تقویم و مناسبتها، اثر راستبهچپ بر تعمیم نتایج خارجی، و سنجش درست تبدیل در پرداختهای خارج از سایت.
تصاویر: تصویرهای این صفحه © بنیاد طراحی تعامل با لایسنس CC BY-SA 4.0 بازنشر شدهاند. باقی تصاویر مطلب اصلی با شرایط Fair Use منتشر شدهاند و اینجا بازتولید نشدهاند؛ در صفحهٔ اصلی قابل مشاهدهاند.
مشاهدهٔ مطلب اصلی
مترجم: سپنتا پویا
طراح ارشد محصول. مقالات تخصصی UI/UX را با حفظ ساختار و لحن نسخهٔ اصلی به فارسی برمیگردانم.
دربارهٔ من